
Unsere Expert:innen haben die spannendsten Power BI Features für euch getestet und zeigen euch, was sie in der Praxis können.
Das Herbst-Update zählt zu den umfangreichsten des Jahres. Microsoft hat es passend zur European Microsoft Fabric + SQL Community Conference in Barcelona veröffentlicht. Wir haben drei Features ausgewählt, die wir besonders spannend finden: die nun allgemein verfügbare agentische Entwicklung samt Remote MCP Server, den neuen Power Query Editor in Power BI Desktop und die Full-Text Search in Semantic Models.
Agentic Development in Power BI (Generally Available) und Remote Authoring MCP Server (Preview)
KI-Agenten zum Erstellen von Semantic Models und Reports sind jetzt allgemein verfügbar – sowohl für neue Projekte auf der grünen Wiese als auch für bestehende Lösungen. Das Prinzip: Ihr gebt dem Agenten zum Beispiel ein Anforderungsdokument oder einen Screenshot des gewünschten Layouts. Er erstellt einen ersten Entwurf, den ihr anschließend prüft und verfeinert, statt jedes Mal bei null anzufangen.
Der Agent erhält Kontext über Fabric IQ und Work IQ (eure Daten und Semantik) sowie über Skills von Microsoft, der Community oder eurem eigenen Team. Dadurch kennt er auch eure Modellierungs- und Reporting-Konventionen. Eine zentrale Rolle spielt das powerbi-authoring-Plugin im GitHub-Repository microsoft/skills-for-fabric. Es unterstützt jetzt auch Reports auf Remote Semantic Models im Service und eine deutlich größere Auswahl an Visuals, darunter Custom Visuals. Mit der Power BI Desktop Bridge kann der Agent seine Änderungen in einer laufenden Desktop-Instanz neu laden und per Screenshot selbst überprüfen.
Besonders interessant ist der neue Remote Power BI Authoring MCP Server (Preview): Er läuft vollständig in der Cloud und muss daher weder lokal installiert noch gewartet werden. So können erstmals auch Mac-User damit arbeiten. Der Remote Server bietet dieselben Authoring-Funktionen wie der lokale. Microsoft empfiehlt ihn, wenn keine lokale Entwicklung erforderlich ist – zum Beispiel, um ein Direct Lake Semantic Model auf einem Lakehouse anzulegen. Das erledigt der Agent mit nur einem Tool Call. Der lokale MCP Server bleibt die richtige Wahl, wenn mit Power BI Desktop, PBIP- oder TMDL-Dateien gearbeitet wird.
Ein Tipp für die Governance: Ebenfalls neu ist eine Einstellung am Semantic Model. Damit können Personen mit Schreibrechten verhindern, dass User mit reinem Lesezugriff das Modell über Copilot oder Microsofts MCP Tools abfragen.
Neuer Power Query Editor (Preview)
Seit Mai gibt es in Power BI Desktop bereits die moderne „Get Data”-Erfahrung als Preview. Jetzt folgt der komplette moderne Power Query Editor. Die Engine bleibt dieselbe, die Oberfläche ist aber komplett überarbeitet. Wer bereits mit Dataflow Gen2 in Fabric arbeitet, wird sich sofort zurechtfinden.
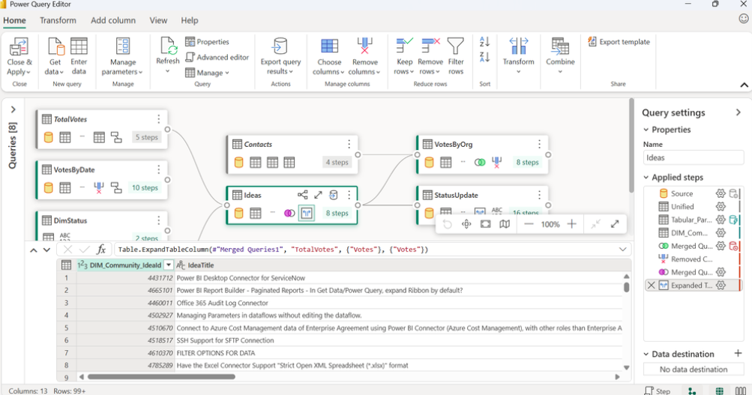
Die wichtigsten Neuerungen für uns im Überblick: Endlich gibt es Transparenz beim Query Folding: Jeder Step zeigt, ob er foldet. Im neuen Query Plan seht ihr genau, an welcher Stelle das Folding abbricht. Die Diagram View visualisiert die Abhängigkeiten zwischen euren Queries. Das ist ein echter Gamechanger bei übernommenen Reports mit langen Reference- und Merge-Ketten. Dazu kommen Funktionen, die es bisher nur im Web gab: Rank Column, Cluster Values, Schema View und Query Script View.
Praktisch ist auch der Export als Power Query Template. Damit lassen sich Queries samt Steps und Struktur direkt in einen Dataflow Gen2 importieren, etwa wenn eine Lösung aus dem Desktop in Fabric wandern soll.
Zum Aktivieren setzt ihr unter Datei > Optionen und Einstellungen > Optionen > Vorschaufeatures den Haken bei „New Power Query experience”. Danach den Power Query Editor öffnen. Ein Neustart ist nicht nötig.
Full-Text Search in Semantic Models (Preview)
Kundenfeedback, Support-Tickets, Produktbeschreibungen: Viele Modelle enthalten heute große Mengen an Freitext. Mit klassischen String-Funktionen ist dieser schwer auszuwerten, weil sie nur exakte Zeichenfolgen finden. Full-Text Indexing baut deshalb auf Spaltenebene einen speziellen Suchindex auf, der Wörter statt reiner Zeichenketten versteht. Damit werden Wortformen wie „run”, „running” und „runs” sowie Singular und Plural automatisch erkannt. Stoppwörter werden ignoriert, Phrasensuche ist möglich und kleinere Tippfehler werden per Fuzzy Matching toleriert.
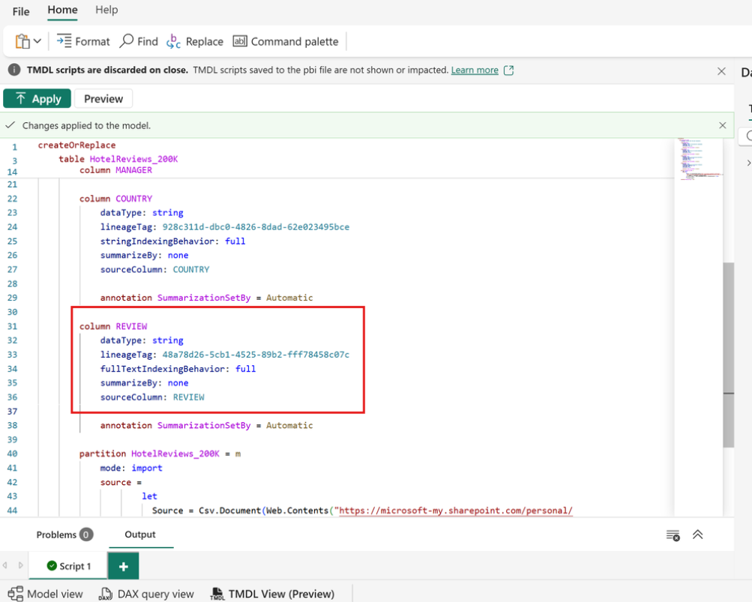
Der Index wird über zwei neue DAX-Funktionen genutzt. TEXTCONTAINS() liefert TRUE, wenn ein Text zur Suche passt, z.B. „alle Bewertungen, in denen der Spa erwähnt wird”. TEXTSIMILARITY() liefert stattdessen einen Relevanz-Score. Damit lassen sich etwa die zehn Bewertungen finden, die am besten zu „good breakfast” passen, auch wenn sie nicht exakt diese Wörter enthalten.
Das Feature funktioniert für Import- und Direct-Lake-Modelle und setzt das Compatibility Level 1708 voraus. In der Preview wird die Indexierung über TMDL im Web oder über XMLA konfiguriert. Für die beste Performance empfiehlt Microsoft den Full Mode. Unterstützung für Power BI Desktop und eine eigene Oberfläche sind angekündigt. Wer vor allem bestehende Textfilter mit SEARCH() oder CONTAINSSTRING() beschleunigen möchte, sollte sich außerdem das parallel vorgestellte String Indexing (Compatibility Level 1707) ansehen.
Viel Spaß beim Ausprobieren!
Bei Fragen dazu oder individuellen Anforderungen rund um Power BI stehen wir jederzeit gerne zur Verfügung – einfach melden, wir freuen uns auf Ihre Nachricht!
Share this

Power BI Insights Juni 2026
Power BI Insights Mai 2026